Chatbot đọc PDF scan bị sai không nhất thiết là do mô hình trả lời kém. Lỗi có thể xuất hiện trước khi chatbot được hỏi: chữ bị nhận nhầm, hai cột bị đọc nối nhau, đơn vị nằm trên tiêu đề bị mất hoặc một hàng ở trang sau bị tách khỏi bảng. Khi dữ liệu đầu vào đã sai nghĩa, câu trả lời có trích dẫn vẫn có thể sai.
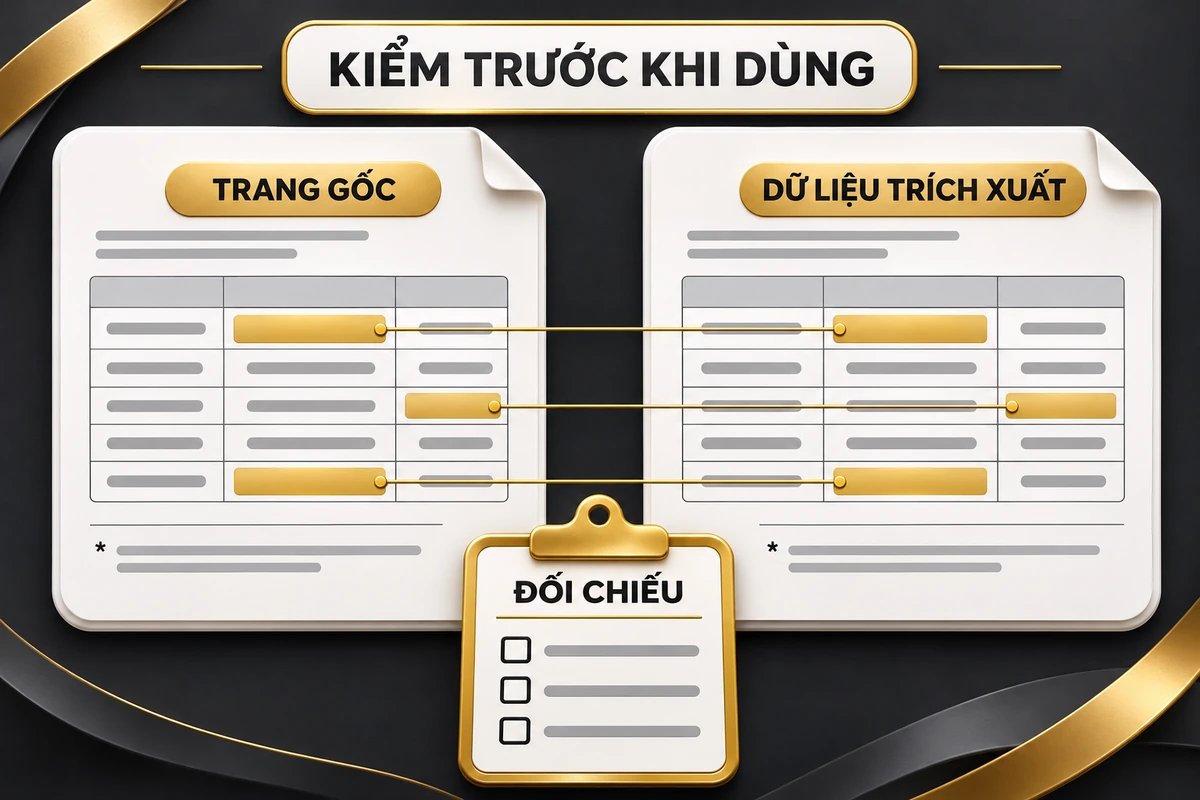
Cách kiểm tra hữu ích là đặt trang gốc cạnh văn bản và bảng đã trích xuất, rồi đối chiếu từng thông tin quyết định nghiệp vụ. Bài này hướng dẫn cách làm với PDF có lớp chữ, PDF scan và bảng phức tạp; kèm bảng mẫu giả định, đáp án cùng danh sách tình huống kiểm tra. Đây là hướng dẫn chuẩn bị dữ liệu, không phải báo cáo chất lượng một dịch vụ OCR hay một hệ thống chatbot đã triển khai.
1. Tách lỗi đọc PDF khỏi lỗi tìm kiếm và lỗi trả lời
Một luồng tra cứu tài liệu có thể gồm nhiều bước: nhận file, trích xuất nội dung, tổ chức dữ liệu, tìm đoạn liên quan rồi tạo câu trả lời. Một số hệ thống còn đọc trực tiếp hình ảnh trang bằng mô hình thị giác. Trước khi sửa prompt hoặc đổi mô hình, cần biết câu trả lời sai bắt đầu ở bước nào.
Hãy chọn một câu hỏi có đáp án rõ trên trang gốc. Nếu bản trích xuất đã đổi “30 ngày” thành “30 tháng”, đó là lỗi đọc hoặc chuẩn hóa dữ liệu. Nếu bản trích xuất đúng nhưng hệ thống lấy nhầm tài liệu khác, cần kiểm bước tìm kiếm. Nếu lấy đúng đoạn mà câu trả lời bỏ mất điều kiện, cần kiểm cách diễn giải. Ba tình huống này cần ba hướng xử lý khác nhau.
Ví dụ, một bảng có cột “thời hạn” và ghi đơn vị “ngày” trong tiêu đề chung. Bộ trích xuất giữ số 30 nhưng bỏ tiêu đề. Dữ liệu không bị mất ký tự số, nhưng đã thiếu ngữ cảnh quan trọng. Khi người dùng hỏi “bao lâu”, mô hình có thể tự đoán đơn vị nếu không có quy tắc dừng hoặc hỏi lại.
Để hiểu toàn bộ luồng, xem trợ lý AI tra cứu tài liệu nội bộ bằng RAG. Nếu chưa xác định được tầng lỗi, bài chẩn đoán chatbot trả lời sai dữ liệu doanh nghiệp giúp khoanh vùng rộng hơn. Phần dưới tập trung vào việc giữ đúng nội dung từ trang PDF sang dữ liệu có thể dùng.
2. Kiểm loại PDF và những chi tiết dễ làm đổi nghĩa
PDF có lớp chữ thường cho phép chọn và sao chép văn bản, nhưng thứ tự đọc hoặc cấu trúc bảng vẫn có thể sai. PDF chỉ chứa ảnh cần một bước nhận dạng chữ hoặc cách đọc hình ảnh phù hợp. PDF đã qua OCR có thể vừa giữ ảnh gốc vừa có lớp chữ ẩn; lớp chữ đó không mặc nhiên chính xác chỉ vì tìm kiếm trong file đã hoạt động.
Tài liệu pypdf về trích xuất văn bản lưu ý trang chỉ chứa ảnh có thể cho kết quả văn bản rất ít hoặc trống và cần xem xét OCR. Vì thế, thử sao chép một đoạn giúp nhận biết đầu vào, nhưng không thay thế kiểm tra hàng, cột và nội dung sau trích xuất.
Trong bộ mẫu tự tạo cho bài này, cùng một nội dung hai trang được lưu thành bản có lớp chữ và bản chỉ chứa ảnh. Kiểm tra cục bộ bằng pypdf đọc được chữ ở bản thứ nhất, còn bản thứ hai không trả chữ. Kết quả này chỉ minh họa giới hạn của đọc lớp văn bản; chưa thử OCR, chưa đo khả năng hiểu bảng và chưa kiểm chatbot trả lời.
| Chi tiết cần kiểm | Lỗi có thể gặp | Cách đối chiếu |
|---|---|---|
| Chữ, mã và dấu | Nhầm ký tự gần giống; mất dấu hoặc dấu phủ định | So từng mã và từ làm thay đổi điều kiện với trang gốc |
| Hàng, cột, ô gộp | Giá trị đúng nhưng gắn sang đối tượng hoặc tiêu đề khác | Kiểm quan hệ mã dòng, tên cột và giá trị cùng nhau |
| Đơn vị, mốc tính | Giữ con số nhưng mất ngày, tháng hoặc điều kiện bắt đầu | Giữ đơn vị và mốc tính trong bản ghi chuẩn hóa |
| Ô trống, dấu gạch | Tự biến dữ liệu chưa biết thành 0 hoặc không áp dụng | Giữ nguyên trạng thái thiếu; chỉ diễn giải khi nguồn định nghĩa |
| Chú thích và phạm vi | Bỏ dấu sao, ngoại lệ hoặc câu giới hạn đối tượng | Nối chú thích đúng hàng; giữ câu xác định phạm vi |
| Bảng qua trang | Mất hàng tiếp theo hoặc coi tiêu đề lặp là dữ liệu | Kiểm trang nối tiếp, mã bảng và tổng danh sách hàng |
Với tài liệu hai cột, cần kiểm thứ tự đoạn chứ không chỉ số lượng chữ. Một câu ở cột trái ghép vào điều kiện ở cột phải có thể tạo ra quy định mà bản gốc không có. Với bảng lồng hoặc ô gộp, nên giữ thông tin hàng và cột được bao phủ, thay vì chỉ tạo một chuỗi chữ dài.
Tài liệu Azure Document Intelligence Layout mô tả việc trích xuất chữ, bảng và cấu trúc tài liệu. Đây là ví dụ cho thấy đọc bố cục là một nhu cầu riêng bên cạnh OCR. Khả năng sản phẩm được mô tả không có nghĩa mọi bảng của doanh nghiệp sẽ được đọc đúng; vẫn cần thử mẫu đại diện.
3. Bảng mẫu và đáp án: kiểm ý nghĩa thay vì chỉ đếm chữ
Ví dụ sau là bảng tự tạo về thời hạn giữ bản nháp nội bộ, chỉ để kiểm tra trích xuất. Các con số không phải chính sách VIN, khuyến nghị lưu trữ hoặc thời hạn pháp lý. Trong PDF mẫu, ba hàng đầu nằm ở trang 1; M-04 nằm ở trang 2 với tiêu đề lặp. Đơn vị “ngày” và phạm vi áp dụng phải đi cùng dữ liệu.
| Mã và loại bản nháp | Giá trị trong mẫu | Điều kiện phải giữ |
|---|---|---|
| M-01: hướng dẫn | 30 ngày | Tính từ ngày tạo; trang 1 |
| M-02: báo cáo | 60 ngày, có dấu chú thích | Tính từ ngày xác nhận, không phải ngày tạo; trang 1 |
| M-03: hồ sơ cần xác minh | Ô thời hạn để trống | Chưa xác định; không suy thành 0; trang 1 |
| M-04: bàn giao | 45 ngày | Tính từ ngày tạo; nối tiếp cùng bảng ở trang 2 |
Mẫu còn có câu giới hạn: “Không áp dụng cho bản gốc đã ký”. Nếu bản trích xuất bỏ câu này, câu trả lời có thể đưa số đúng cho đối tượng sai. Đây là lỗi nghĩa dù chữ và số trong bốn hàng đều được nhận dạng chính xác.
Có thể dùng bốn câu hỏi và đáp án chuẩn sau để đối chiếu:
- M-02 tính thời hạn từ khi nào? Đáp án phải giữ “60 ngày từ ngày xác nhận”, không đổi sang ngày tạo.
- M-03 có thời hạn bằng 0 không? Không đủ dữ liệu để kết luận; ô đang trống và được ghi là chưa xác định.
- M-04 có thuộc bảng này không? Có, hàng nằm ở trang tiếp theo của cùng bảng; không bỏ sót khi ghép dữ liệu.
- Có dùng thời hạn của bảng cho bản gốc đã ký không? Không, phạm vi mẫu loại trừ đối tượng đó.
Đây là đáp án thiết kế cho kiểm thử, không phải kết quả một mô hình đã trả lời. Nếu thử một công cụ, cần lưu riêng kết quả thực tế và đối chiếu. Không chỉnh đáp án chuẩn theo câu trả lời của công cụ chỉ để làm cho phép thử đạt.
Một bản ghi tốt cho M-02 cần giữ mã nguồn DEMO-PDF-01, phiên bản 1, trang 1, mã dòng M-02, loại tài liệu, giá trị 60, đơn vị ngày, mốc bắt đầu là ngày xác nhận và phạm vi bản nháp nội bộ. Không nhất thiết công cụ nào cũng dùng cấu trúc giống nhau; mục tiêu là người kiểm tra có thể lần lại nguồn và giải thích mỗi giá trị.
4. Năm bước chuẩn hóa PDF cho RAG
Bước 1: giữ bản gốc và xác định quyền xử lý
Giữ một bản gốc không chỉnh sửa cùng tên nguồn, phiên bản, người phụ trách và quyền sử dụng. Bản đã xoay trang, tăng tương phản hoặc sửa lớp chữ cần có tên riêng để đối chiếu. Không ghi đè bản gốc rồi mất dấu điều gì đã thay đổi.
Trước khi đưa hồ sơ lên dịch vụ bên ngoài, xác định dữ liệu nào được phép gửi và ai có quyền xem kết quả. Thông tin nhạy cảm không trở nên an toàn chỉ vì đã chuyển sang PDF. Phần phân quyền tài liệu nội bộ cho AI Agent giúp xem xét quyền truy cập ở bước tiếp theo, còn quyền đưa file vào công cụ xử lý cần được quyết định ngay từ đầu.
Bước 2: chọn nhóm trang khó trước khi xử lý toàn kho
Chọn trang có chữ nhỏ, scan nghiêng, con dấu chồng chữ, nhiều cột, bảng qua trang và chú thích quan trọng. Thêm một trang đơn giản làm đối chứng. Một công cụ đọc tốt trang giới thiệu chưa chứng minh nó đọc đúng bảng điều kiện ở cuối tài liệu.
Nếu còn file nguồn có cấu trúc như bảng tính hoặc tài liệu soạn thảo, cân nhắc dùng bản xuất phù hợp thay vì cố đọc lại ảnh scan. Tuy nhiên, phải xác nhận bản nguồn đó có cùng nội dung và phiên bản với tài liệu được phép sử dụng. File dễ xử lý nhưng đã cũ không phải đầu vào tốt hơn.
Bước 3: kiểm chất lượng ảnh và khả năng của công cụ
Kiểm trang đủ sáng, chữ còn nét, đúng chiều và không bị cắt mép. Tăng kích thước ảnh không tự phục hồi ký tự đã mất. Với trang không đọc được, nên xin bản rõ hơn hoặc chuyển kiểm tra thủ công; không để mô hình tự điền chữ theo phỏng đoán.
Hướng dẫn Amazon Textract nhấn mạnh chất lượng đầu vào, ngôn ngữ được hỗ trợ và rủi ro ở bảng có ô gộp; tài liệu cũng khuyên xem độ tin cậy theo mức nhạy cảm của công việc. Danh sách ngôn ngữ trên trang này khi kiểm tra ngày 03/11/2026 không có tiếng Việt, nên không nên suy rằng công cụ đó phù hợp hồ sơ tiếng Việt chỉ vì hỗ trợ PDF.
Khi chọn OCR hoặc bộ phân tích bố cục, hãy kiểm ngôn ngữ, loại bảng, cách trả tọa độ trang và khả năng xử lý tài liệu có quyền truy cập hạn chế. Không coi một điểm tin cậy cao là bằng chứng rằng đúng đơn vị, đúng đối tượng hoặc đúng chính sách.
Bước 4: chuẩn hóa nhưng không tự bổ sung dữ liệu thiếu
Gắn đơn vị từ tiêu đề vào đúng các hàng thuộc phạm vi của tiêu đề; nối chú thích với đối tượng mà nó giải thích. Giữ số trang và vùng nguồn khi công cụ cung cấp. Với tiêu đề nhiều tầng, bản ghi cần giữ đủ đường dẫn cột để phân biệt các nhóm có tên giống nhau.
Ô trống, dấu gạch và số 0 phải được phân biệt. Chỉ chuyển dấu gạch thành “không áp dụng” khi tài liệu định nghĩa như vậy. Nếu không rõ ô gộp bao phủ hàng nào, đánh dấu cần kiểm tra thay vì sao chép giá trị xuống mọi dòng.
Khi chia dữ liệu thành đoạn để tra cứu, không tách một dòng bảng khỏi tiêu đề, đơn vị và chú thích cần thiết để hiểu dòng đó. Có thể giữ bản bảng có cấu trúc cùng phần mô tả ngắn, nhưng cả hai cần liên kết về cùng nguồn và phiên bản. Mục tiêu là bảo toàn ý nghĩa trước khi tối ưu tìm kiếm.
Bước 5: đối chiếu và chỉ cho dùng phần đã kiểm tra
Người kiểm tra mở trang gốc bên cạnh kết quả, đọc các trường quyết định và ghi kết quả đạt, không đạt hoặc chưa đủ thông tin. Trường quan trọng sai cần được sửa hoặc loại khỏi phạm vi sử dụng cho đến khi có căn cứ. Không lấy một tỷ lệ đúng trung bình để bỏ qua lỗi đảo đơn vị hoặc mất câu phủ định.
Sau khi sửa, chạy lại đúng tình huống từng sai và những trường liên quan. Ghi công cụ, phiên bản, thiết lập và ngày xử lý để sau này biết vì sao kết quả thay đổi. Cách quản lý nguồn, người phụ trách và trạng thái được sử dụng có trong mẫu chuẩn bị dữ liệu cho chatbot doanh nghiệp.
Khi bản trích xuất đã đúng nhưng bot vẫn chọn sai đoạn, chuyển sang kiểm tra câu hỏi và kết quả truy hồi RAG; sửa OCR thêm sẽ không giải quyết đúng tầng lỗi này.
5. Tám tình huống cần kiểm trước khi nạp cả kho
Danh sách này là bộ kiểm riêng cho chất lượng đọc tài liệu. Nó không thay thế kiểm thử tìm kiếm, quyền truy cập hoặc câu trả lời của toàn hệ thống RAG. Với từng mục, lưu trang nguồn, dữ liệu trích xuất thực tế, đáp án mong đợi và cách xử lý khi chưa đạt.
- Trang chỉ chứa ảnh: xác nhận luồng có cách đọc hình ảnh phù hợp; không đưa văn bản trống vào kho rồi coi là đã xử lý.
- Mã và dấu phủ định: kiểm ký tự dễ nhầm, dấu tiếng Việt và từ “không” trong điều kiện; lỗi làm đổi nghĩa phải được ghi riêng.
- Tiêu đề gộp: xác nhận mỗi giá trị thuộc đúng nhóm cột, không chỉ kiểm ô chứa số.
- Đơn vị ở ngoài bảng: bảo đảm bản ghi vẫn có đơn vị và mốc tính, kể cả khi tiêu đề nằm ở trang trước.
- Ô trống: giữ trạng thái chưa biết như M-03; không tự điền 0 hoặc sao chép giá trị hàng trên.
- Chú thích và ngoại lệ: giữ mốc “ngày xác nhận” của M-02 cùng giới hạn chỉ dùng bản nháp nội bộ.
- Bảng qua trang: M-04 vẫn có mặt sau khi ghép, còn tiêu đề lặp không trở thành bản ghi mới.
- Nguồn thiếu hoặc không đọc rõ: đánh dấu cần bổ sung và ngăn dùng phần chưa đủ căn cứ cho câu trả lời quyết định nghiệp vụ.
Thay vì chỉ báo “OCR đúng nhiều chữ”, nên ghi số trường quan trọng đã kiểm, số trường sai, số trường chưa xác minh và loại lỗi. Mẫu số phải rõ: đang tính trên ký tự, ô bảng, hàng hay câu hỏi. Với một bộ mẫu nhỏ, hãy công bố phạm vi mẫu thay vì suy rộng thành tỷ lệ chính xác của toàn kho.
Đầu ra để bàn giao nên gồm bản gốc, bản đã xử lý, dữ liệu chuẩn hóa, đáp án đối chiếu, lỗi còn mở và danh sách phần được phép dùng. Nếu chưa có người xác nhận phần nghiệp vụ, ghi trạng thái đó rõ ràng; đừng ghi “đã duyệt” chỉ vì quá trình trích xuất chạy xong.
6. Câu hỏi thường gặp khi chatbot đọc PDF scan bị sai
PDF chọn được chữ thì có thể bỏ qua OCR và kiểm bảng không?
Có thể không cần chạy OCR lại nếu lớp chữ hiện tại đáp ứng yêu cầu, nhưng vẫn phải kiểm dữ liệu trích xuất. Chọn được chữ không chứng minh thứ tự đoạn, hàng cột và chú thích đã đúng. Chạy OCR lại mọi file cũng có thể tạo thêm sai khác không cần thiết.
Đổi sang mô hình mạnh hơn có sửa hết lỗi PDF không?
Không có căn cứ để hứa như vậy. Mô hình khác có thể xử lý tốt hơn một loại tài liệu, nhưng nếu hệ thống chỉ đưa cho nó dữ liệu đã mất đơn vị hoặc thiếu trang thì phần thông tin đó vẫn cần được khôi phục từ nguồn. Thử có đối chiếu trên cùng bộ mẫu mới giúp biết thay đổi có ích ở đâu.
Có nên chuyển toàn bộ bảng thành đoạn văn?
Chỉ khi cách biểu diễn mới giữ đủ quan hệ cần dùng và có thể kiểm lại. Với bảng nhiều chiều, chuyển thành đoạn dài dễ làm mờ quan hệ giữa dòng, cột và ngoại lệ. Có thể dùng mô tả ngắn đi kèm bảng có cấu trúc, giữ liên kết nguồn thay vì bỏ bảng hoàn toàn.
Nên xử lý bao nhiêu file để bắt đầu?
Chọn theo loại lỗi và mức quan trọng, không theo một con số cố định. Một nhóm nhỏ có đủ trang scan xấu, bảng ô gộp, bảng qua trang và tài liệu tiếng Việt cần dùng sẽ có ích hơn nhiều trang giống nhau. Mở rộng sau khi biết nhóm nào đạt, nhóm nào cần công cụ khác hoặc kiểm thủ công.